阿拉丁Aladdin

开放世界目标检测模型

结合 Grounding DINO、YOLO 与 SAM,用自然语言定位目标、提取对象轮廓,再由跟踪服务关联视频中的连续出现。适用于现场巡检、物品查找与作业片段复核。

  • Grounding DINO
  • YOLO
  • SAM
  • 视频跟踪

业务痛点

开放世界目标检测模型
01输入与范围
02文本引导目标检测
03应用成果
查找对象超出固定类别

查找对象超出固定类别

固定类别检测器适合熟悉对象,临时新增的查找任务需要结合描述与现场词表。

  • 01

    输入与范围

    图像与视频、目标描述与类别词表、摄像头、时间与区域、模型版本与现场样本

  • 02

    文本引导目标检测

    Grounding DINO 根据自然语言描述查找对象,在画面中呈现目标类别与位置。

  • 03

    应用成果

    目标类别、位置与分割轮廓,直观呈现巡检对象。

模型功能与架构

Grounding DINO 理解目标描述,YOLO 识别已适配类别,SAM 提取对象轮廓,独立跟踪服务衔接连续视频。检测、分割与跟踪相互协同,服务现场巡检、物品查找和区域分析。
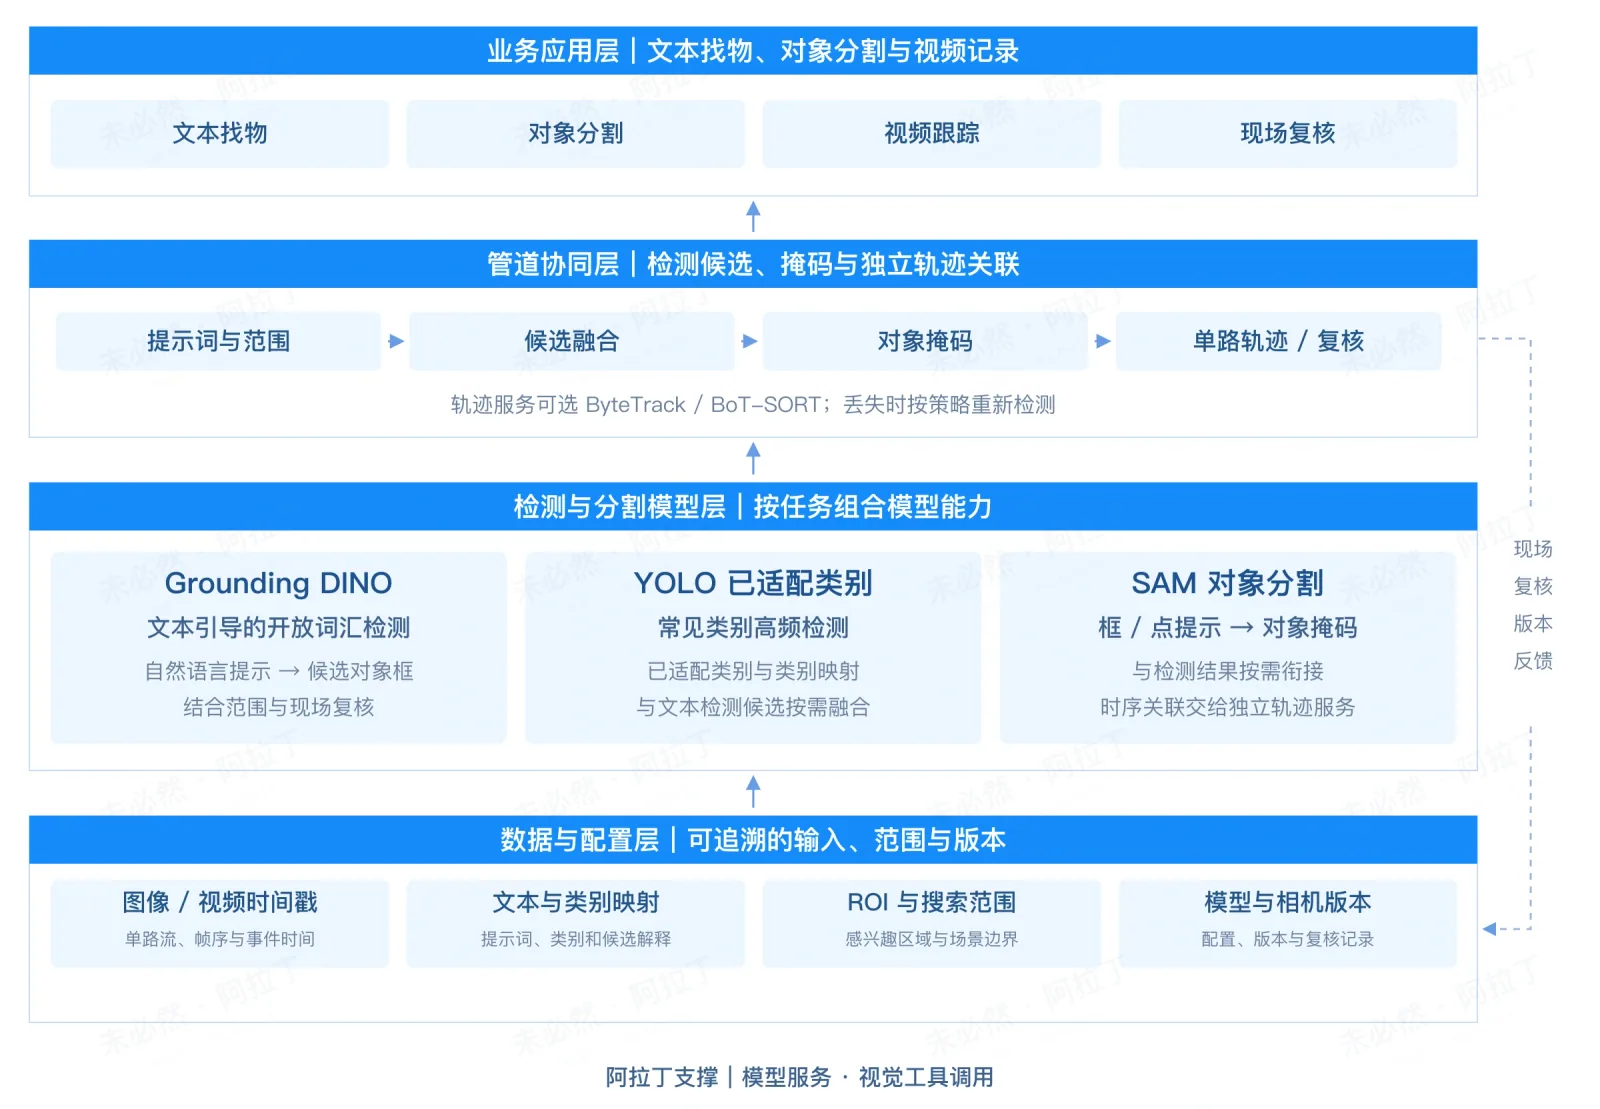
开放世界目标检测模型:Grounding DINO 理解目标描述,YOLO 识别已适配类别,SAM 提取对象轮廓,独立跟踪服务衔接连续视频。检测、分割与跟踪相互协同,服务现场巡检、物品查找和区域分析。

模型功能

01

文本引导目标检测

Grounding DINO 根据自然语言描述查找对象,在画面中呈现目标类别与位置。

02

多检测器协同

YOLO 识别已训练的常见类别,与文本检测结果合并,减少重复目标,兼顾日常巡检与临时查找任务。

03

SAM 对象分割

SAM 从目标框中提取对象轮廓,分离背景与相邻物体,支持区域分析和三维场景关联。

04

视频目标跟踪

连接独立跟踪服务,关联目标在连续画面中的位置,支持移动轨迹查看、遮挡后重检和事件片段回放。

通过自然语言查找画面中的目标

输入

图像、目标描述与指定区域

视觉模型

模型输出

  • 识别目标类别与位置
  • 按描述查找相关对象
  • 展示目标框与匹配结果

应用场景

文本检测、对象分割与跟踪的 AI 效果示意

巡检目标与物品查找

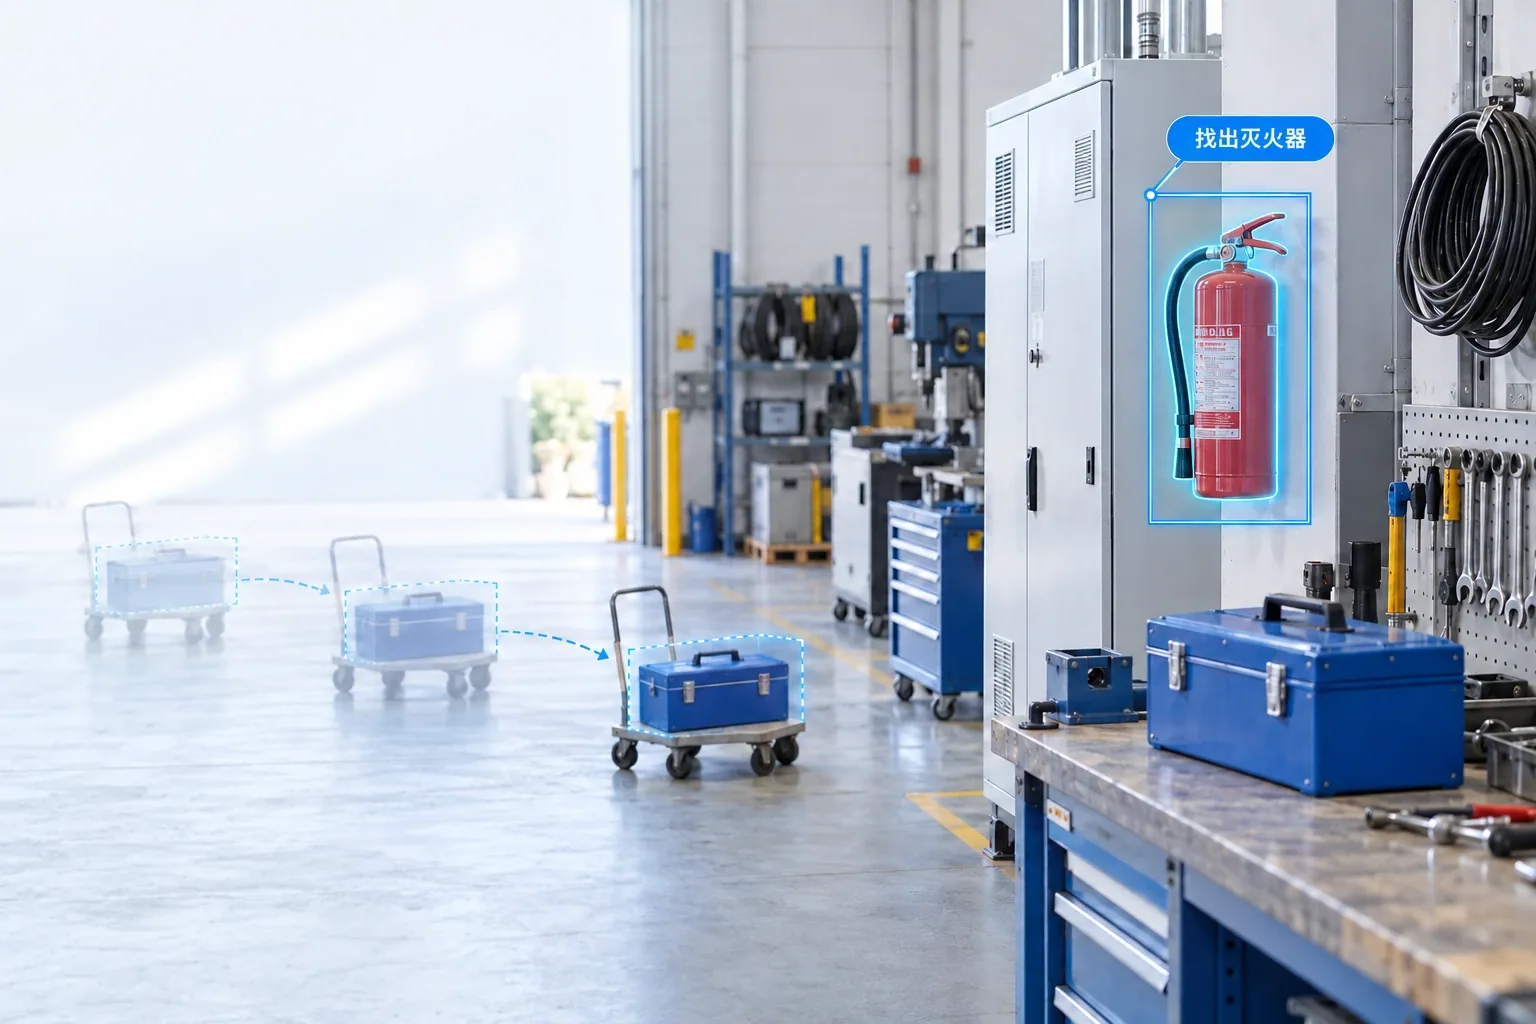
按描述查找灭火器、工具箱等已验证对象,把目标位置和轮廓展示在原始画面上。

  • 输入与对象

    巡检图像、对象描述与现场词表

  • 文本引导目标检测

    Grounding DINO 根据自然语言描述查找对象,在画面中呈现目标类别与位置。

  • 应用成果

    目标类别、位置与分割轮廓,直观呈现巡检对象。

模型优势

01

自然语言定义查找目标

通过对象名称或特征描述发起查找,支持临时巡检中的目标检测。

02

检测与分割协同

根据目标位置提取轮廓,分离对象与背景,支持区域及空间分析。

03

目标移动连续观察

连接独立跟踪服务,观察移动过程,支持遮挡后重新检测与片段回放。

04

现场对象灵活扩展

结合现场词表和样本适配设备、工具与物料,复用已有检测和跟踪配置。

应用案例

文本检测、对象分割与跟踪的 AI 效果示意
工业巡检

灭火器与工具箱查找

通过对象描述定位巡检画面中的灭火器与工具箱,展示目标框和分割轮廓,支持物品检查与区域分析。
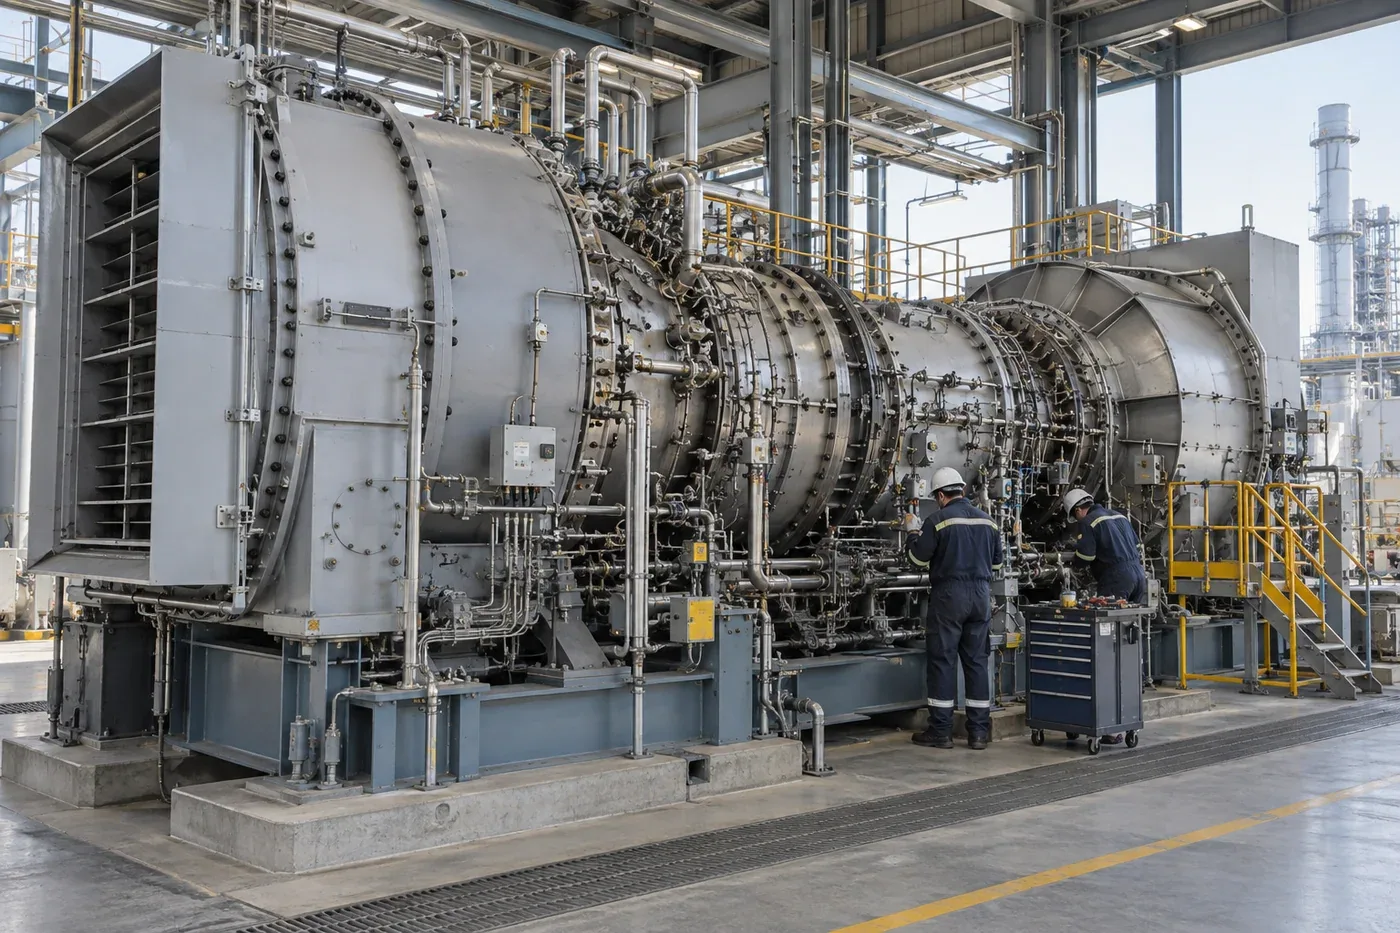
工业设备与现场场景示意
设备区域

设备与物料对象分割

在指定区域中识别已适配设备与物料,提取可见边界,为对象统计、区域检查和后续空间分析提供输入。
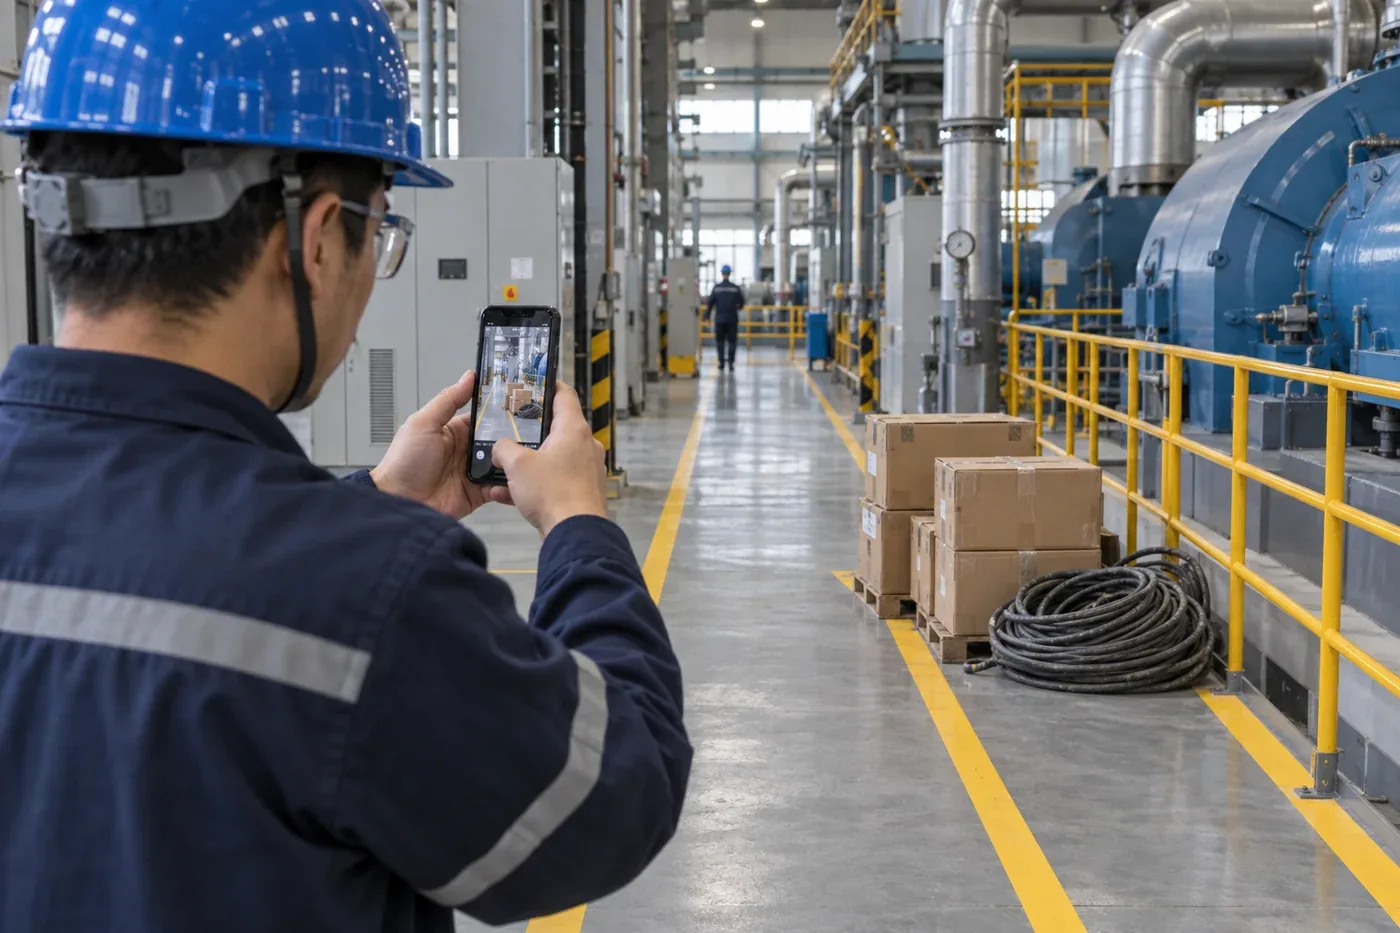
现场巡检场景示意
视频回看

物品移动跟踪

关联目标在连续画面中的位置,展示移动轨迹,目标丢失后触发重检,按时间定位相关视频片段。

当前案例:灭火器与工具箱查找

咨询模型应用 · 开放世界目标检测模型

结合 Grounding DINO、YOLO 与 SAM,用自然语言定位目标、提取对象轮廓,再由跟踪服务关联视频中的连续出现。适用于现场巡检、物品查找与作业片段复核。