资源管理
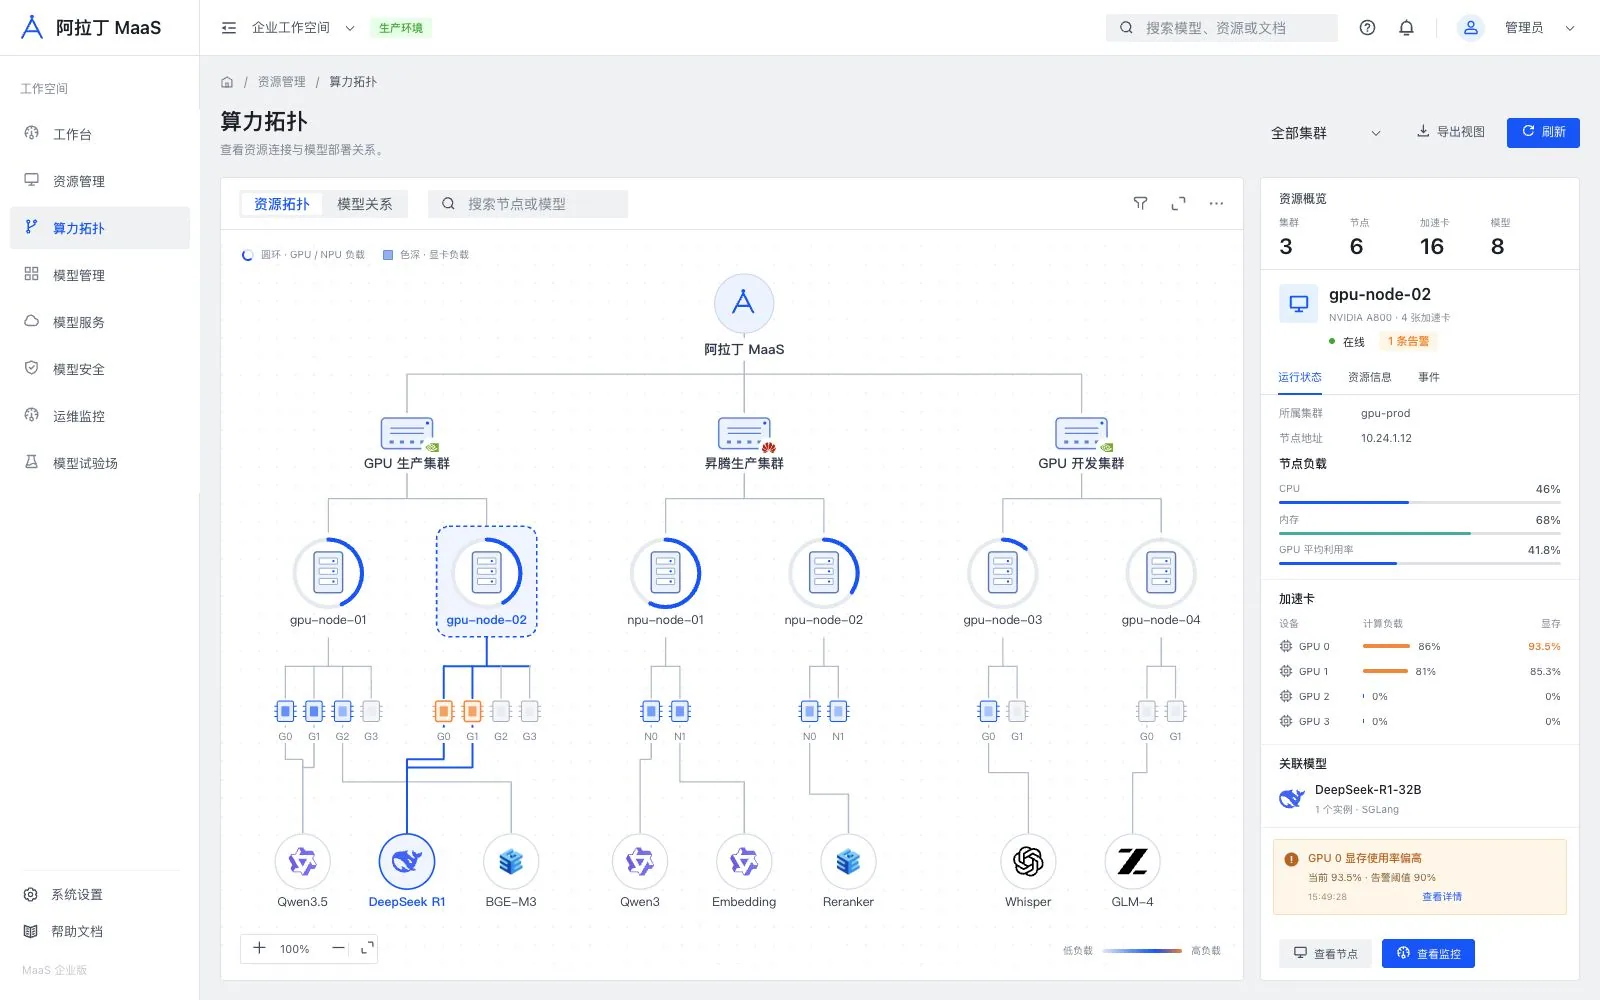
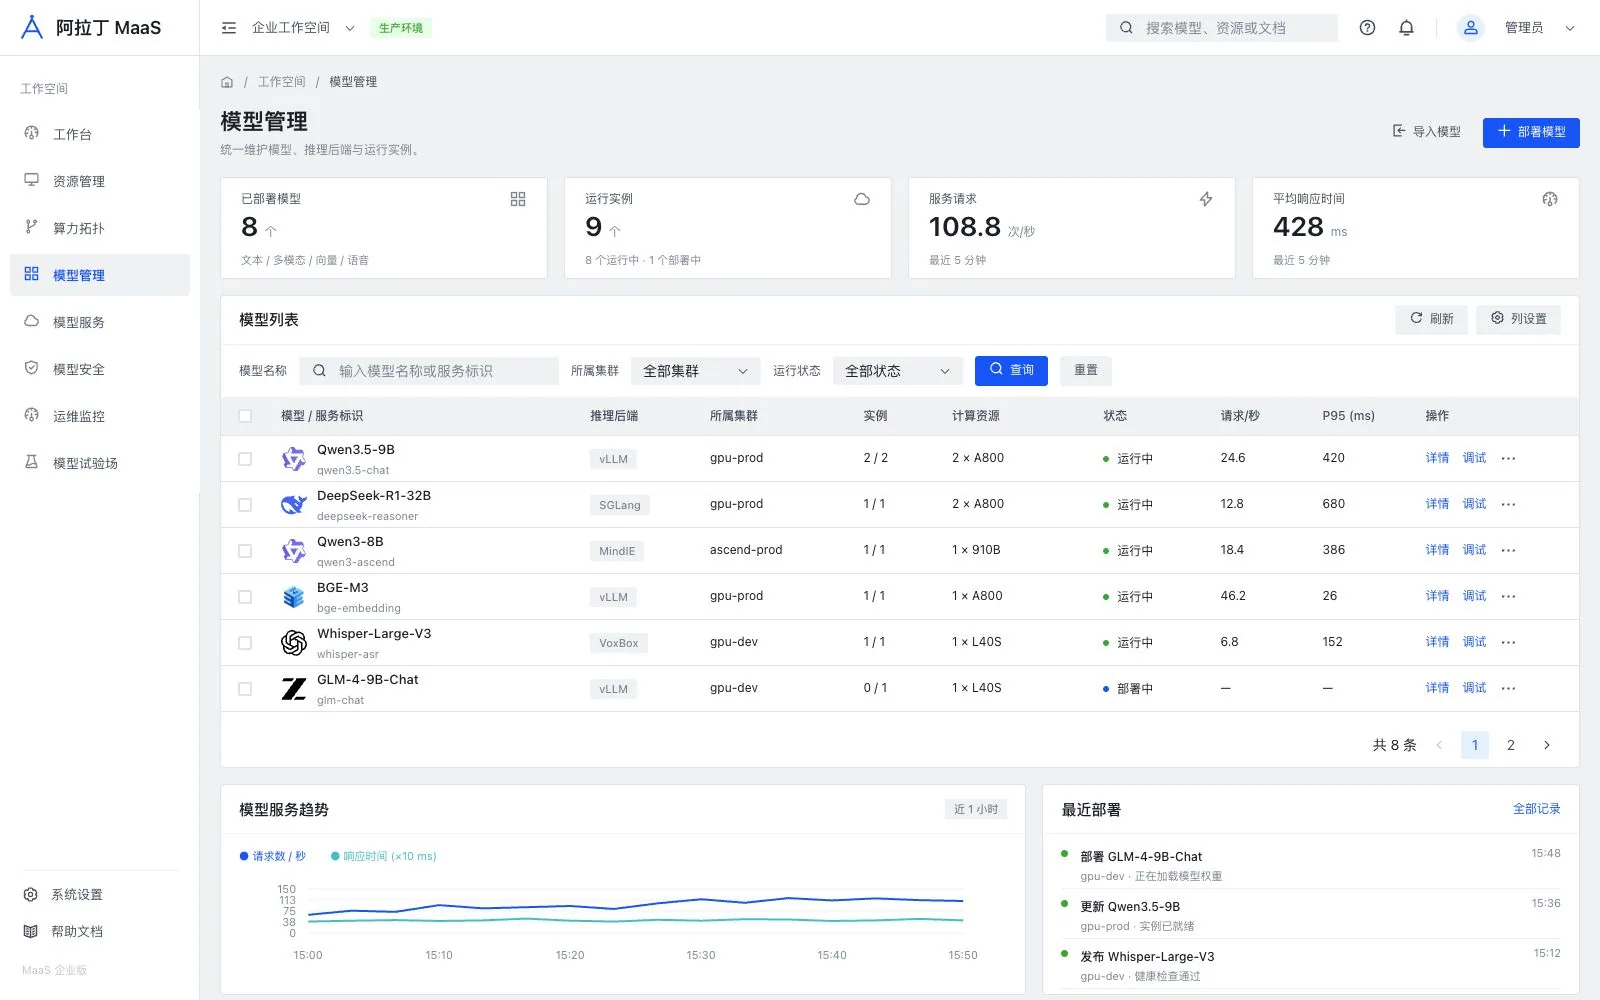
统一管理集群、节点与 GPU / NPU,按模型需求选择设备和部署位置。
企业 AI 应用交付平台:一个严肃的 AI 应用,构建如此简单。

阿拉丁 MaaS · 企业 AI 能力管理平台
统一纳管企业自有模型、算力与第三方模型 API,向团队和应用分发 AI 服务,集中管理权限、用量、费用与运行监控。

统一管理集群、节点与 GPU / NPU,按模型需求选择设备和部署位置。
从模型文件、推理框架到运行实例,完成模型部署与服务发布。
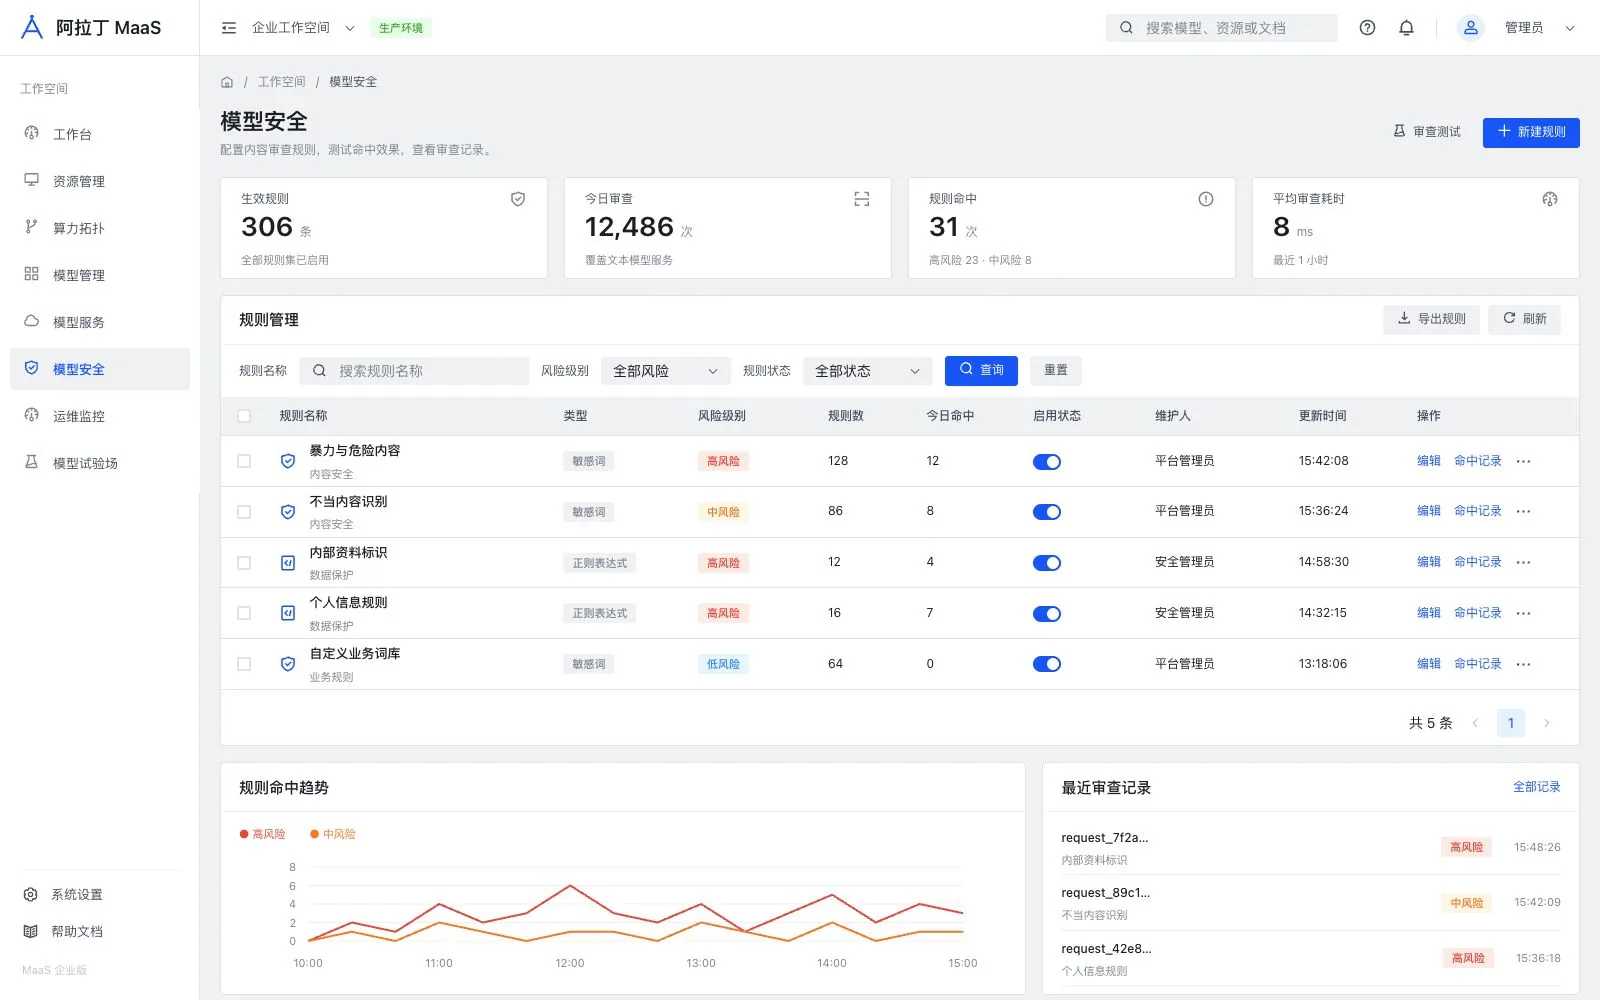
配置敏感词与正则规则,测试审查策略,管理模型服务的访问权限。
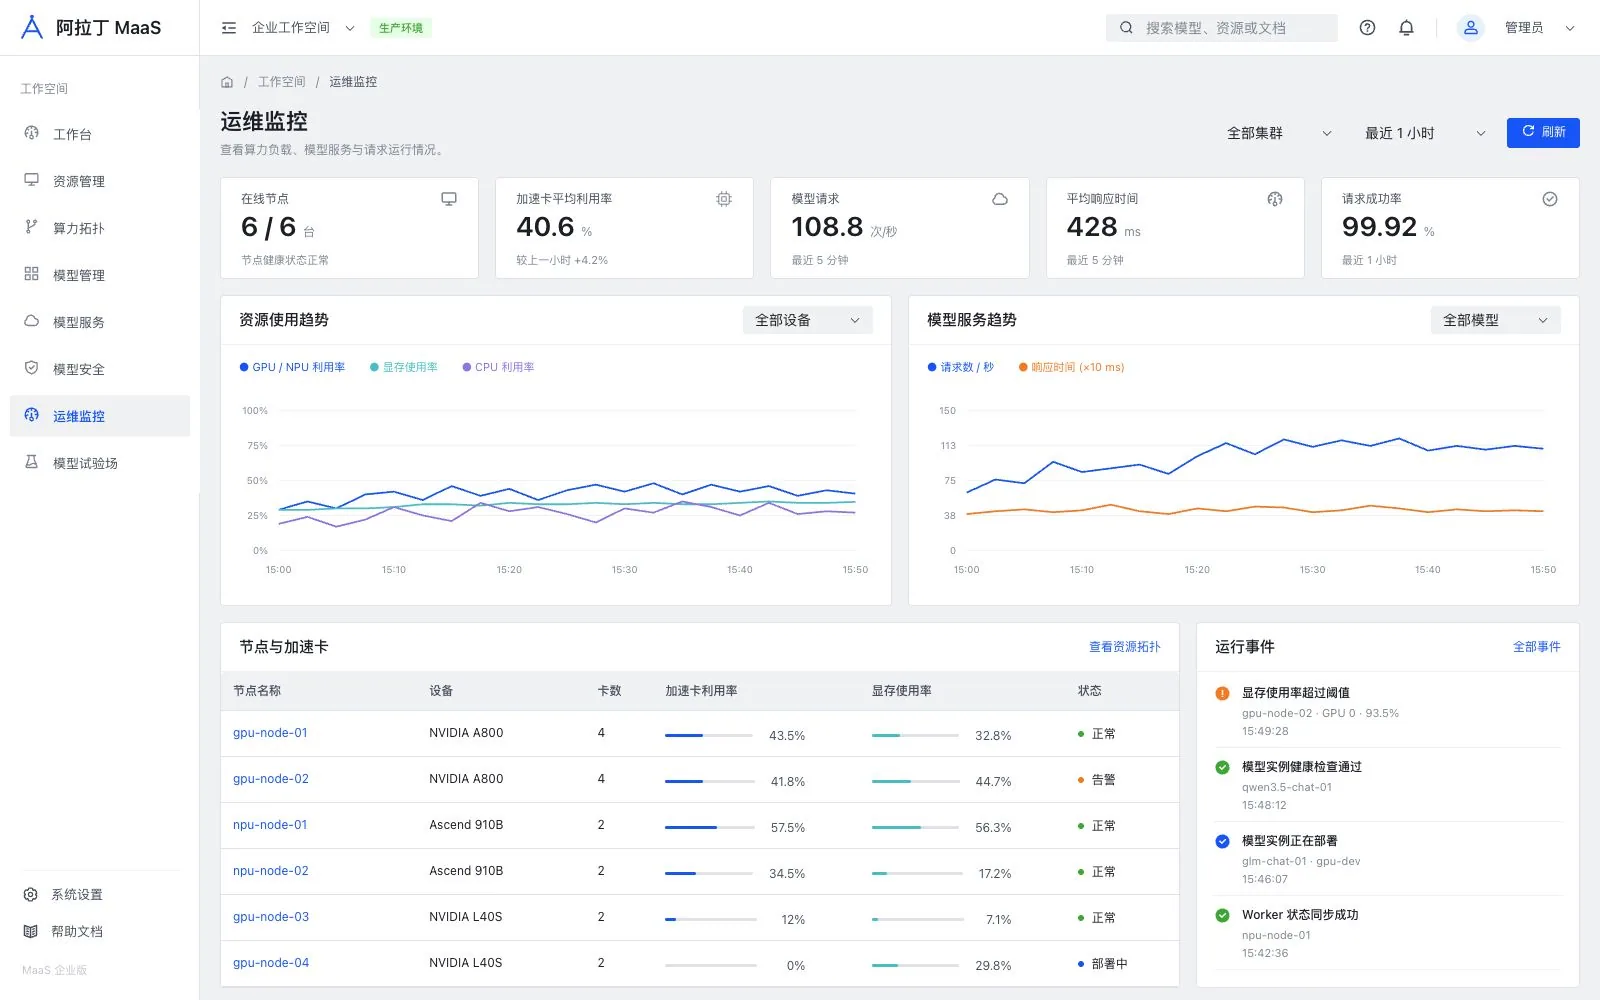
查看设备状态、模型用量和请求记录,定位异常,评估服务容量。
在一张拓扑图里查看集群、节点、GPU / NPU 与模型实例,掌握设备负载、部署关系和运行告警。

汇集主流厂商的文本、多模态、向量、图像与语音模型,按需求选择,按设备部署。
具体模型版本、精度及设备组合,以所选推理后端和部署验证结果为准。
管理敏感词和正则规则,测试审查效果,查看命中记录,控制模型服务访问。
查看显卡状态、显存占用、模型请求和响应时间;出现异常时,从请求记录开始排查。
统一接入第三方 API 与自有模型,向团队分发服务,集中管理权限、用量与费用。
配置供应商地址与密钥。
按团队和应用分发模型服务。
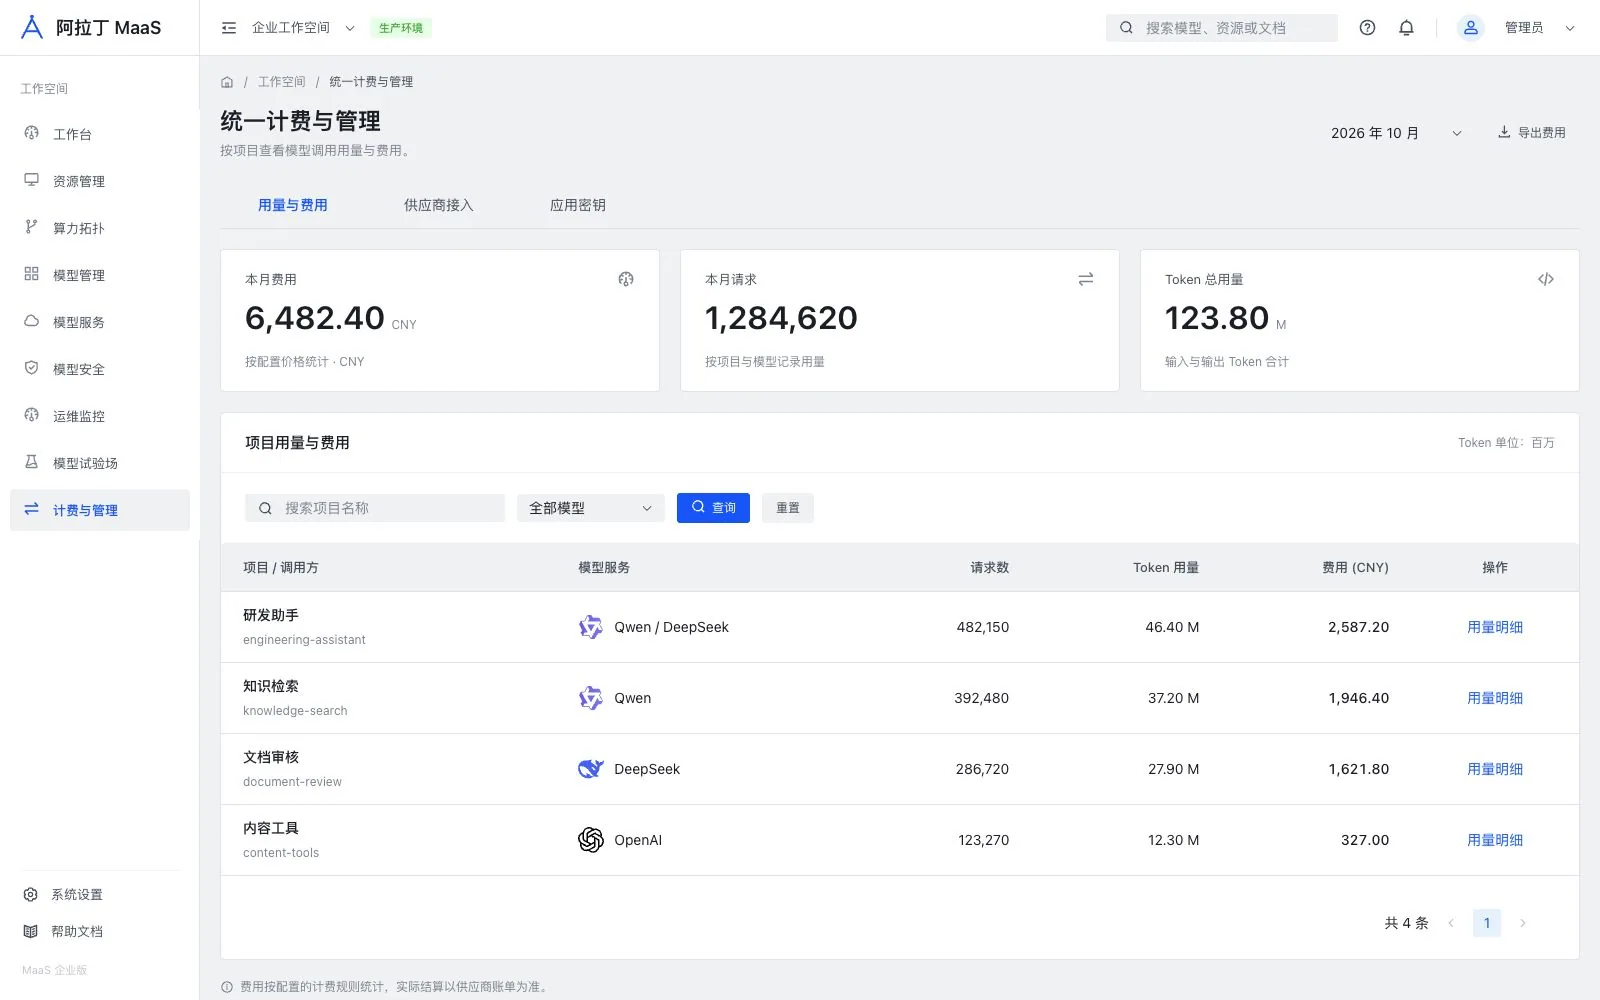
按项目查看用量与费用。
跟踪请求状态与响应时间。

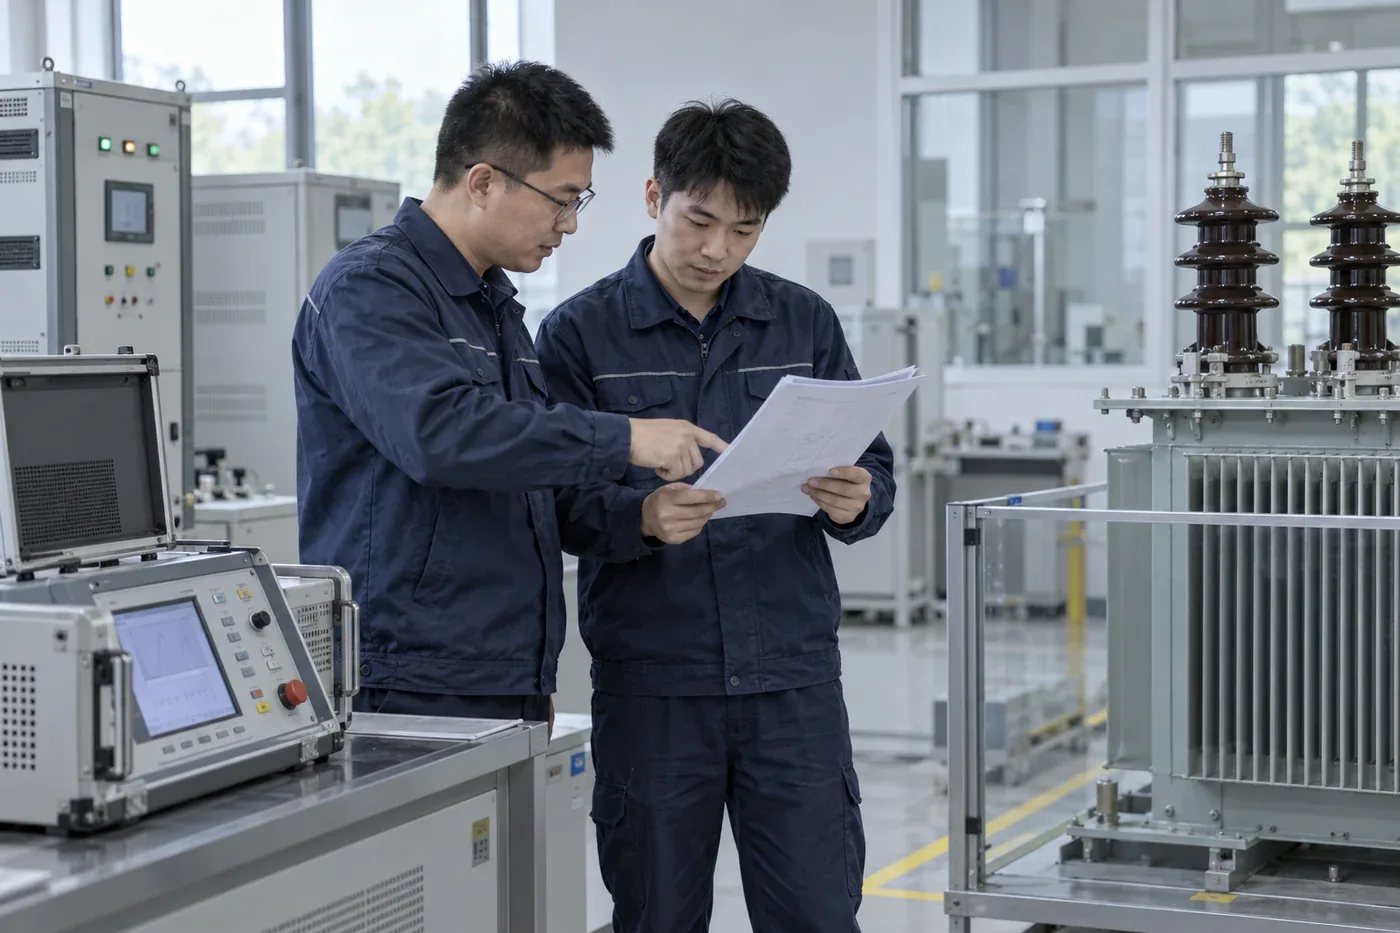
集团同时使用 GPU 与昇腾 NPU,可集中管理各集群的设备和运行状态,为不同模型选择相应的推理后端,并按团队查看资源使用情况。
集中部署文本、向量和语音模型,通过模型路由向项目提供服务。各项目使用独立的 API 密钥,管理员统一维护模型与运行环境。
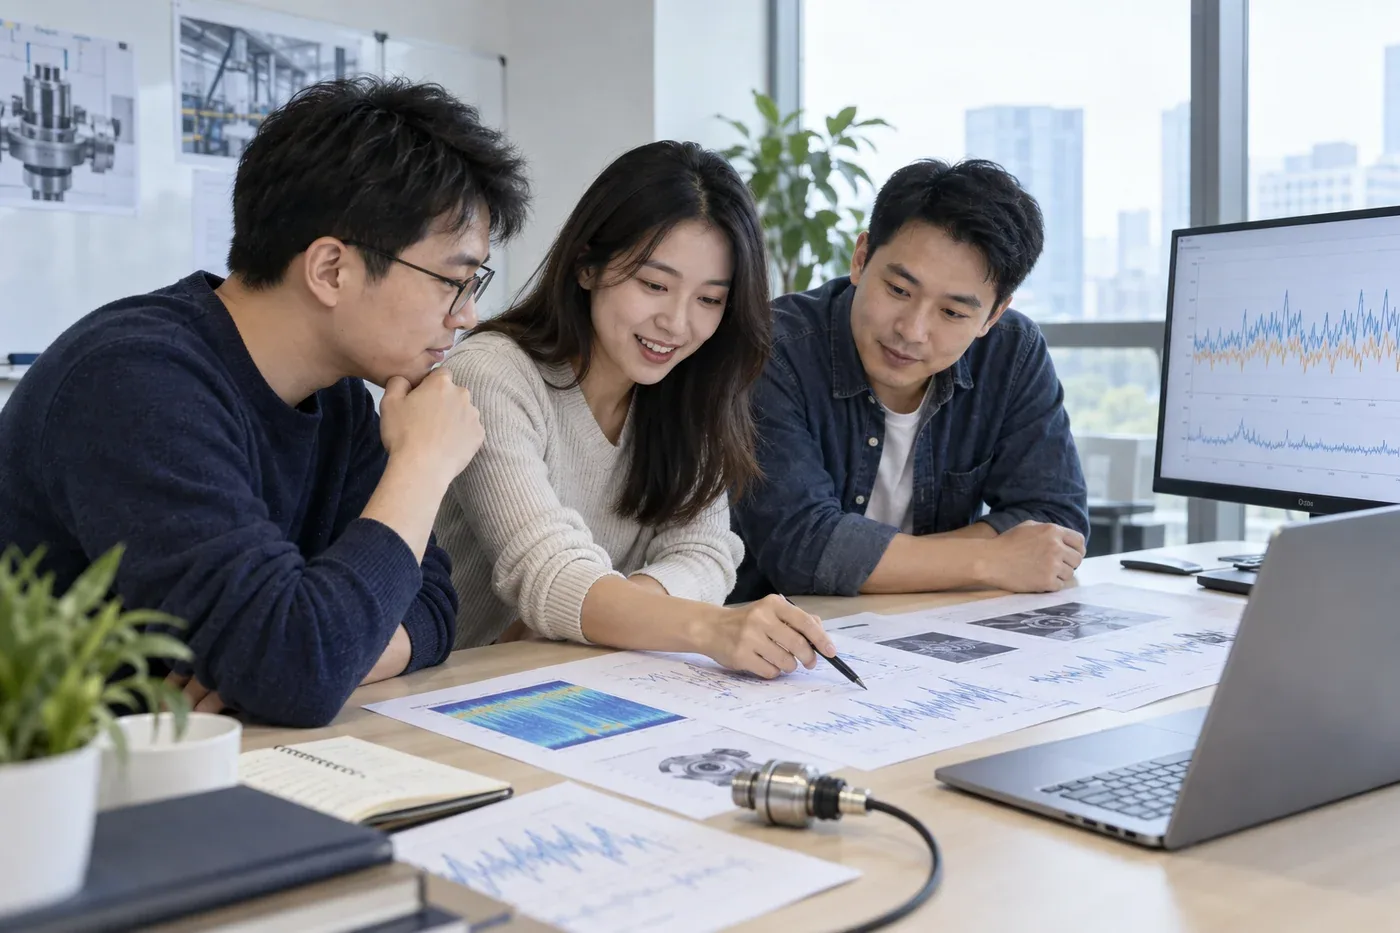
在共享算力上部署不同模型,配置敏感词审查规则,保留调用与命中记录,再用统一的测试条件比较模型表现和资源消耗。

集团同时使用 GPU 与昇腾 NPU,可集中管理各集群的设备和运行状态,为不同模型选择相应的推理后端,并按团队查看资源使用情况。

集中部署文本、向量和语音模型,通过模型路由向项目提供服务。各项目使用独立的 API 密钥,管理员统一维护模型与运行环境。

在共享算力上部署不同模型,配置敏感词审查规则,保留调用与命中记录,再用统一的测试条件比较模型表现和资源消耗。

集团同时使用 GPU 与昇腾 NPU,可集中管理各集群的设备和运行状态,为不同模型选择相应的推理后端,并按团队查看资源使用情况。

集中部署文本、向量和语音模型,通过模型路由向项目提供服务。各项目使用独立的 API 密钥,管理员统一维护模型与运行环境。

在共享算力上部署不同模型,配置敏感词审查规则,保留调用与命中记录,再用统一的测试条件比较模型表现和资源消耗。
以上为基于平台能力编写的场景示例。
可以在同一平台组织和管理不同集群与设备。部署时仍需分别选择适合设备的模型、精度和推理后端;统一纳管不等于不同厂商的显卡可以直接混合推理。
模型目录包含千问、DeepSeek、智谱 GLM、Kimi、Gemma 等系列,以及向量、图像和语音模型。内置 vLLM、SGLang、MindIE、VoxBox 推理后端。具体型号与设备组合,应结合框架要求进行部署验证。
先核对操作系统、驱动、可用显存、存储和网络条件,再接入 Worker 节点、导入模型文件,并选择对应的推理后端部署。具体操作可查看服务手册中的资源接入与模型部署章节。
包括敏感词与正则规则、分类管理、审查测试、命中记录,以及模型服务访问管理。规则需要结合实际场景持续维护,内容审查也需要保留必要的人工复核。
通过模型路由发布服务,并为调用方配置相应的 API 密钥。业务系统使用服务地址发起请求,管理员可在平台查看模型用量、请求状态与资源运行情况。
可以配置供应商的 API 地址与密钥,通过模型路由向团队和应用分发服务。调用方使用独立的应用密钥,管理员集中管理访问权限,并查看用量、费用和请求状态。费用统计按配置的计费规则计算,实际结算以供应商账单为准。
把自有模型、算力和外部 API 纳入一个平台,让服务分发、权限和费用都有据可查。