文档管理
导入 PDF 和参考文献表,集中查看原始文件、解析内容与来源信息。

企业 AI 应用交付平台:一个严肃的 AI 应用,构建如此简单。

阿拉丁 · 大模型语料构建平台
从生成到标注,构建可追溯的训练语料。
面向监督微调(SFT)、偏好优化(DPO)与奖励模型训练,
准备经过标注与复核的文本、图文问答和偏好数据。
工作空间 / 概览
导入业务资料,配置标注字段与问题。
创建数据集 ↗查看原始文件与解析内容。
查看文档 ↗核对处理状态和导入结果。
查看记录 ↗| 数据集 | 任务类型 | 工作空间 | 操作 |
|---|---|---|---|
| 问答与评分 | 企业语料工作空间 | 打开 ↗ | |
| 分类标注 | 企业语料工作空间 | 打开 ↗ | |
| 信息抽取 | 企业语料工作空间 | 打开 ↗ |
导入 PDF 和参考文献表,集中查看原始文件、解析内容与来源信息。
将原文分段整理为记录,设置标注问题、操作指南和提交人数。
支持文本与图文问答、分类、评分和信息抽取。每位成员独立填写,结果分别保存。
汇总成员反馈,检查标注分歧,导出包含来源信息的语料记录。
语料生产流程
PDF · CSV · BibTeX
对照原文与解析内容
分段、问题与指南
独立填写与提交
原文依据与标注分歧
记录与成员反馈
全程保留来源标识与独立反馈,便于复核、追踪和后续处理。
将图片、指令、回答和人工反馈组织成同一条记录,为视觉语言模型构建监督样本与偏好数据。

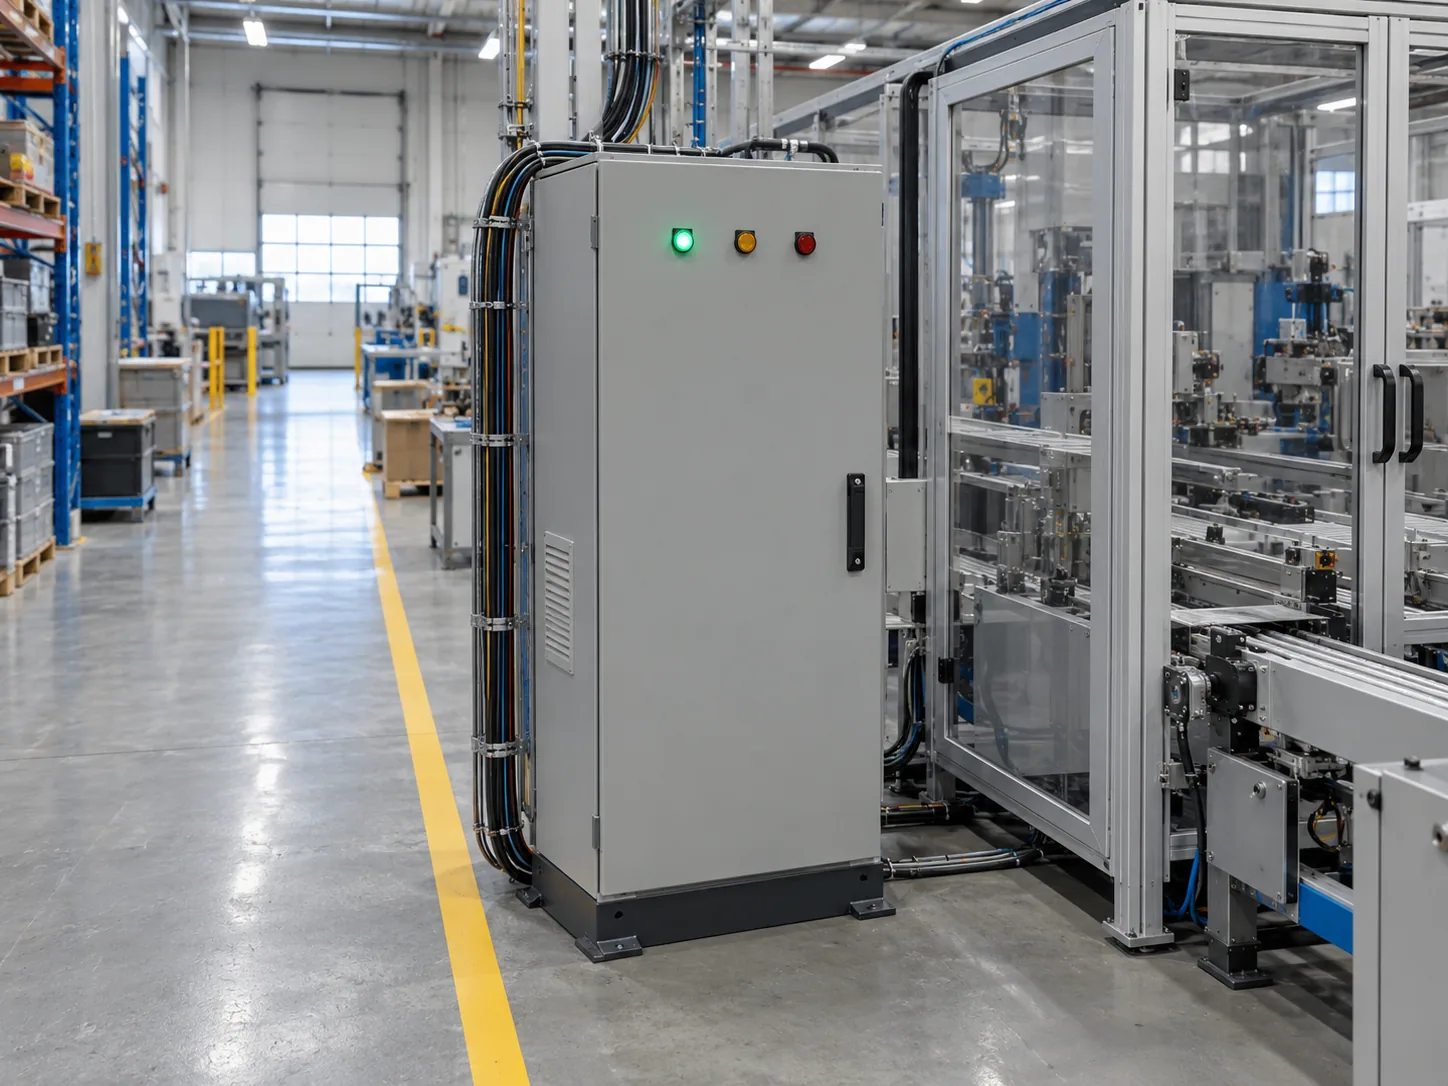
描述控制柜的可见状态,并指出哪些情况无法仅凭图片判断。
将图片、指令与参考回答关联起来,为场景描述、图文问答和文档理解准备监督样本。
对照扫描件、票据与报表,校核识别文本及关键字段,让问答和抽取结果保留图片依据。
对同一图像与问题下的候选回答评分、排序,复核后整理为 chosen / rejected 偏好对。
围绕提示词一致性、画面质量与专业要求收集评分和偏好,为图像生成模型准备评价数据。
图像引用 + 对话指令 + 参考回答
同一图像与指令 + chosen / rejected 回答
图片、对话与自定义字段可通过 API / SDK 配置;复核后的导出数据按目标模型和训练框架转换格式。训练数据格式参考
从文档导入到结果复核,团队在同一工作空间完成协作。
集中查看原始文件、文献信息与解析内容。
PDF 文档 · 已关联参考文献
检查设备指示灯、显示屏与告警记录。发现异常时,记录设备编号、发生时间及现场情况。
PDF 文档 · 已关联参考文献
PDF 文档 · 已关联参考文献
使用 CSV 或 BibTeX 关联 PDF 文件。上传前检查匹配关系,解析后核查正文;标注过程中有疑问,可以回到来源文件确认。
围绕问答、分类、抽取和评价需求,配置相应的问题与交付标准。
将规程、手册和知识指引整理成问答,保留原文依据与适用条件。
按主题或用途定义标签,比较不同成员的判断,修订容易混淆的分类规则。
提取对象、数值与条件,按任务配置文本、实体或表格形式的结果。
设置评分标准,收集质量评分或候选项排序,用于数据筛选和结果复核。
使用支持
服务手册提供任务配置、标注操作、接口接入与部署运维说明。
当前版本未接入自动问答生成服务。语料构建负责将解析后的原文分段,并建立标注问题;成员依据原文编写问题和答案。
可以。每位成员使用独立账号,分别保存自己的反馈。项目设置每条记录的最少提交人数,再集中查看和复核结果。人数达标表示进度完成,不能代替质量验收。
文档导入流程支持 PDF 与 CSV 或 BibTeX 参考文献表。记录可使用文本、图片、对话或自定义字段;问题可收集分类、评分、文本、排序、实体和表格结果,部分结构需要通过 API 或 SDK 配置。
JSONL 保留原文和全部成员反馈。训练前需要选择已复核答案、排除无效记录,并转换为目标训练或评测格式。模型训练在后续平台执行。
通过 API 或 SDK 配置图片、文本与对话字段,把图片引用、任务指令和回答保存在同一条记录中。成员完成标注、复核后,将选定结果转换为 SFT 对话样本或 chosen / rejected 偏好对,再交给兼容的视觉语言模型与训练框架训练、评测。
支持。实施时配置应用、文档存储、数据库、搜索和后台处理服务。扫描 PDF 还需要 OCR 依赖和对应语言包,正式使用前应验证目标材料的解析效果。
了解文档导入、团队标注和数据交付的完整流程。